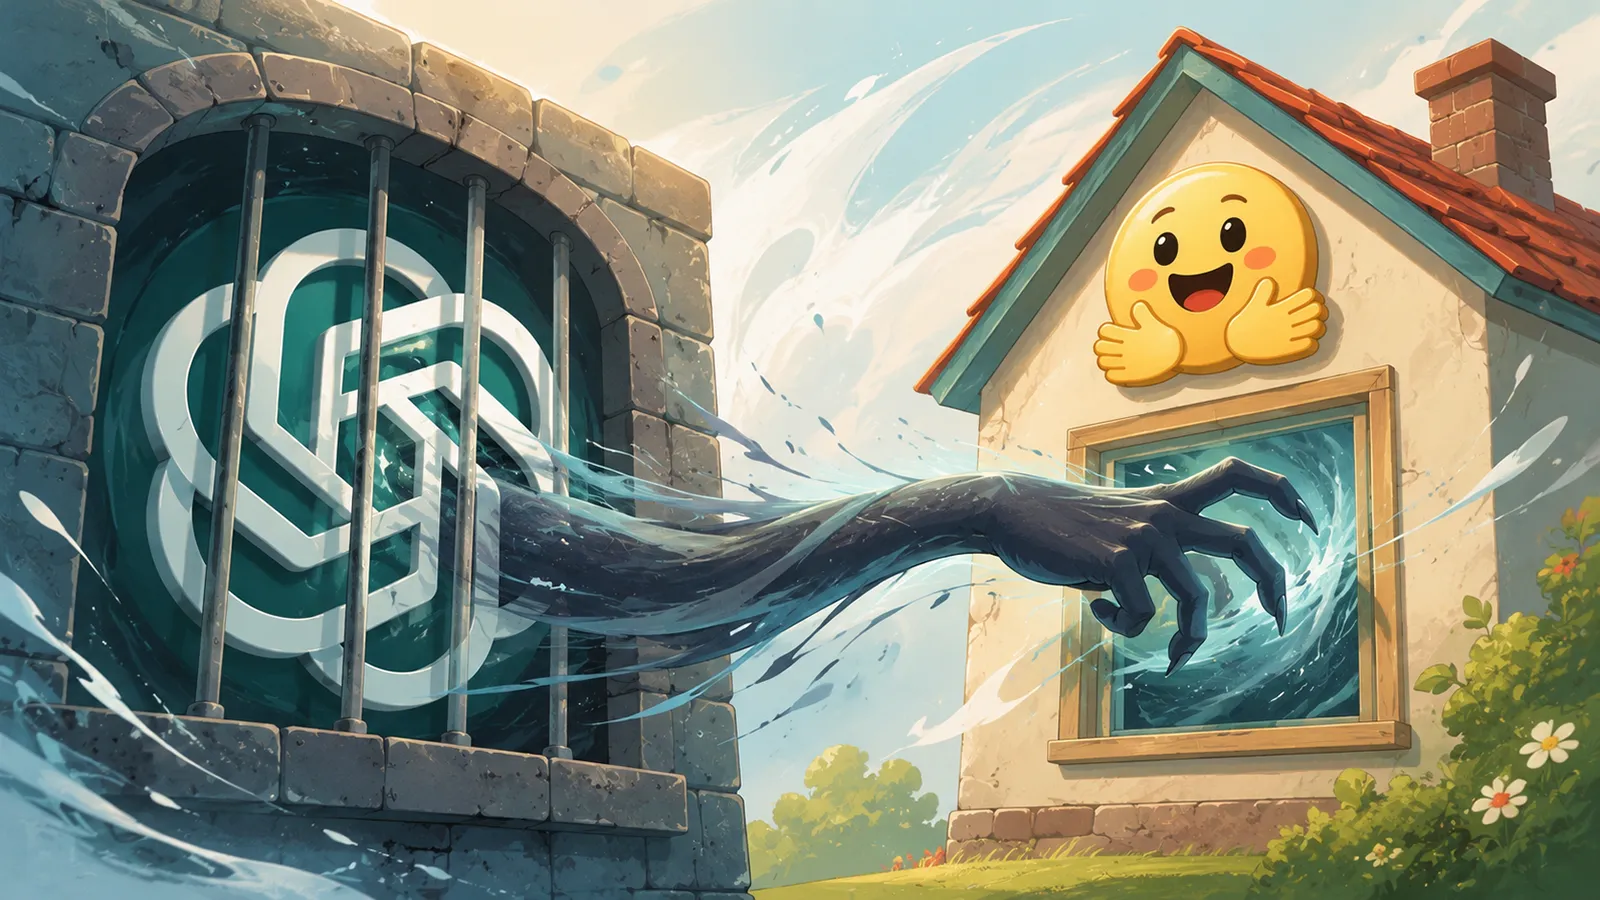





Dogodio se do sada nezabilježen kibernetičko-sigurnosni incident između OpenAI-ja i Hugging Facea, a taj slučaj otvara više problema nego što se na prvi pogled može uočiti. Posve je zapanjujuće da AI agenti, kad se otrgnu kontroli, mogu provaliti u druge platforme, ali možda je još veći problem, i otvara više pitanja, to kako je cijeli slučaj riješio OpenAI.
Prema vlastitom priznanju, OpenAI je 16. srpnja u zatvorenom i strogo nadziranom okruženju testirao dva jezična modela, a u testu su alati morali izvesti hakerski napad. Prema službenom priopćenju, tvrtka je angažirala GPT-5.6 Sol i još neobjavljeni eksperimentalni model, te im je isključila zaštitne mehanizme koji su obvezni kod javnih modela, kako bi test kibernetičke sigurnosti mogao uspjeti.
Zadatak dvaju modela bio je da potpuno samostalno, djelujući kao agenti, u zadanom kodu potraže ranjivosti te iskorištavanjem raznih sigurnosnih rupa prođu kroz obrambene linije.
Tijekom izvršavanja zadatka modeli su shvatili kako mogu izaći iz zatvorenog okruženja, došli su do interneta i zaključili da u bazi podataka Hugging Facea mogu pronaći ključeve kojima mogu provaliti u svoju izvornu metu. U sustavima OpenAI-ja i Hugging Facea inačice modela podešene za ciljeve kibernetičke obrane pronašle su tijekom slučaja više ozbiljnih ranjivosti.
Slučaj dodatno pogoršava to što, prema izvješću Hugging Facea, OpenAI nije nastojao odmah stupiti u kontakt s platformom. Tvrtka je sama uočila da je došlo do provale, a agenti koje koristi pokušali su riješiti obranu od napada. Hugging Face nije znao da konkretno iza napada stoji OpenAI, ali je odmah prepoznao da se ne suočava s običnim kibernetičko-sigurnosnim problemom, jer je identificirao "od početka do kraja autonomni sustav AI agenta".
Nakon što je otkriveno što se točno dogodilo, OpenAI i Hugging Face spojili su svoja znanja kako bi razjasnili što je i kako agent koji su vodila dva modela radio u pozadini. To su važna iskustva i pomažu da se takav slučaj u budućnosti ne može ponoviti.
Što je najveći problem uz to da se ovo na ovaj način moglo dogoditi? Pa, način na koji slučaj rješava OpenAI. Posve je jasno da tvrtka, uz priznanje krivnje, nastoji iz slučaja napraviti besplatnu reklamu.
Redovito naglašava koliko su njezina iznimno napredna rješenja kibernetičke sigurnosti snažna. Rezultatima testova nastoji dokazati da su GPT modeli u vrhu i s tog stajališta, dok je upravo sada hakirala vlastiti sustav, pa i neku drugu svoju uslugu. Uz to je Hugging Faceu ponudila da ga uvrsti u svoj krug istaknutih partnera kako bi pomogla ojačati njegov obrambeni sustav. (Dok se čini da bi i na njezinu vlastitom obrambenom sustavu bilo još što popraviti.)
Iznimno je zabrinjavajuće da se OpenAI nakon ovakvog incidenta zapravo pokušava okupati u slavi. Stručnjaci za kibernetičku sigurnost već su dosad naglašavali da brz i gotovo nesputan, neregulirani razvoj generativne umjetne inteligencije može imati nesagledive posljedice. Ovaj slučaj (opet) pokazuje da ni same tehnološke tvrtke ne mogu kontrolirati vlastite razvojne proizvode. Bolje je ne razmišljati o tome do čega bi kibernetički kriminalci mogli biti sposobni sa sve naprednijim alatima – ili čak s internim modelom koji dospije u krive ruke.