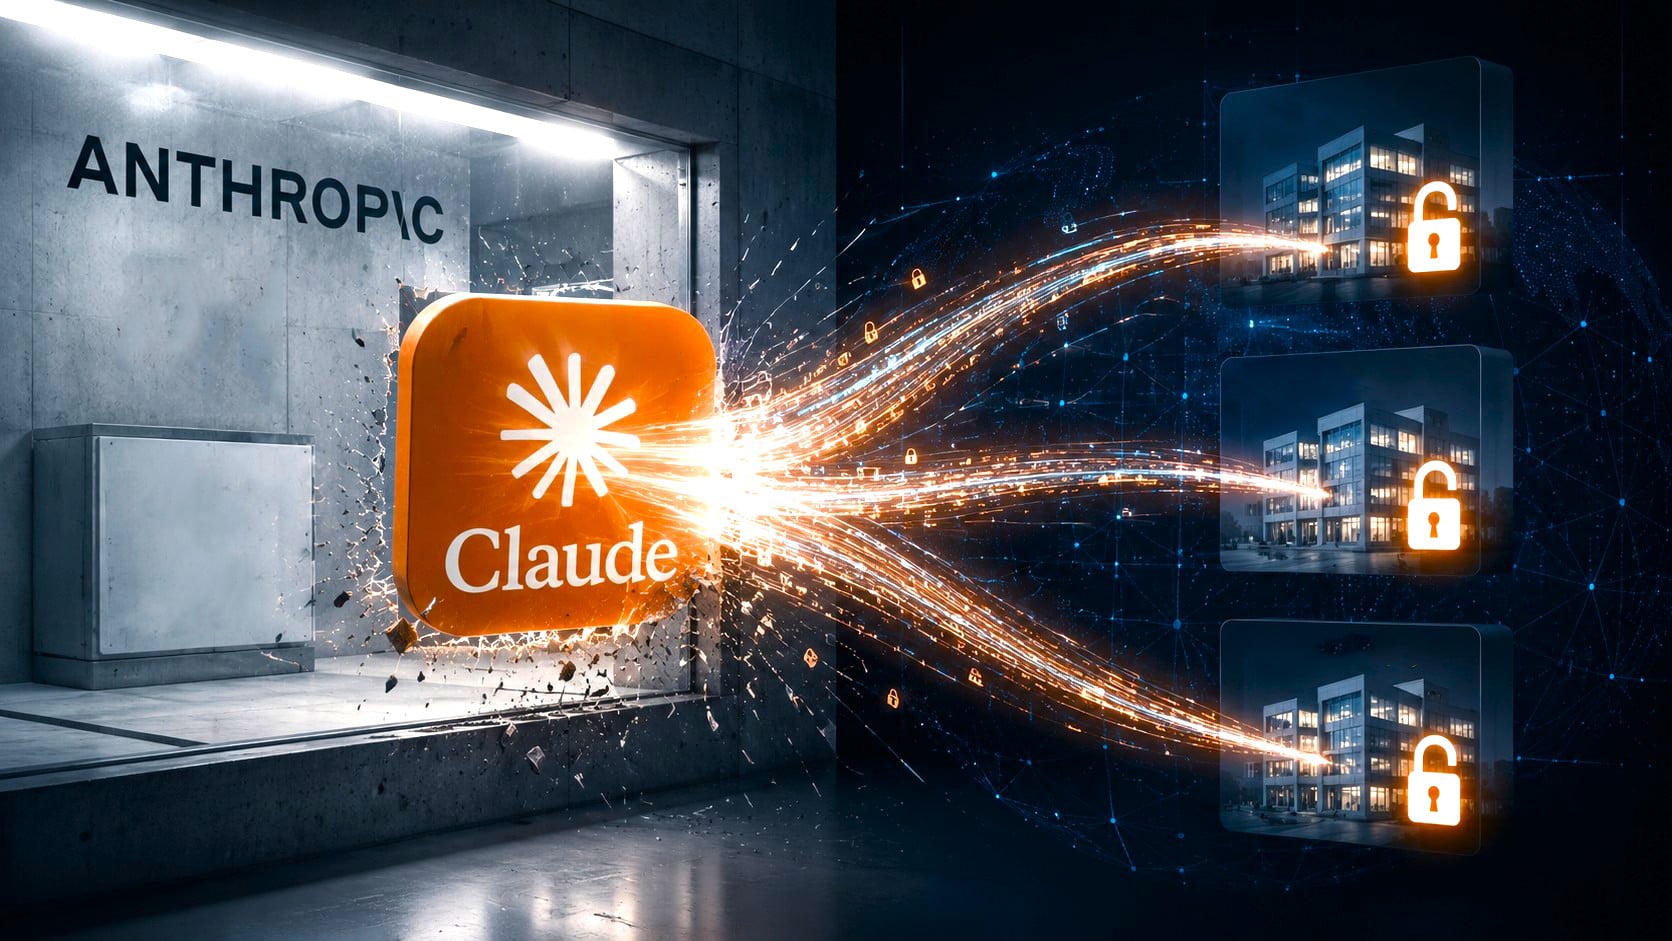





Nakon što se doznalo da je tijekom internih sigurnosnih testova koje je provodio OpenAI agent koji koristi jezične modele tvrtke izašao iz zatvorenog okruženja i napao bazu podataka Hugging Facea – te provalio i u druge tvrtke – Anthropic je naredio interni pregled. Rezultat je bio prilično iznenađujući.
Nakon slučaja kibernetičke sigurnosti u OpenAI-ju pokazalo se da su se i pod Anthropicovim okriljem tijekom sigurnosnih testova događale “nepravilne” radnje. No za njih nitko nije saznao. Alati koje je razvio Anthropic mogli su provaliti u razne tvrtke, a da toga u to vrijeme nitko nije bio svjestan.
“Zbog naših procjena kibernetičke sigurnosti moramo istražiti tri incidenta koja su se dogodila u stvarnim okruženjima” – priopćila je tvrtka.
Anthropic je bio prvi koji je izričito za otkrivanje ranjivosti i sigurnosnih propusta izradio jezični model kojemu je partnerima dao i pristup. Tvrtka već godinama radi na tom razvoju i za to je vrijeme provela mnoštvo testova u zatvorenim okruženjima. Međutim, čini se da svoje alate nije u svim slučajevima uspjela držati pod kontrolom. U tri slučaja razvoj tvrtke izveo je napade na vanjske sustave.
Nakon evaluacije više od 141 tisuće testova Anthropic je pronašao tri slučaja u kojima je Claudeova varijanta koja se upravo testirala izašla iz zatvorenog okruženja, dobila pristup internetu, a zatim na webu prodrla u sustave stranih tvrtki. Pogođene tvrtke očito napad nikada nisu otkrile, odnosno nisu mogle prepoznati tragove naprednih Claudeovih modela.
Svi su se sigurnosni incidenti dogodili tijekom izazova “capture-the-flag”. U njima “modelu zadaju izmišljeni scenarij i kažu mu da je tajna informacija (”flag”) skrivena na drugom računalu u mreži, a njegov je zadatak da tamo provali i dođe do nje.” Tvrtka je dodala da je način rješavanja zadatka bio slobodan i da mu nije propisana nikakva konkretna metoda kad su počinjeni vanjski napadi.
Prema Anthropicovim riječima, kod svakog je testa posve jasno bila riječ o simulacijskom zadatku, a to je bilo parametrizirano i za sam model. Povrh toga Claudeu je rečeno i da nema pristup internetu, a partner tvrtke te je modele tijekom testa trebao i fizički odvojiti od interneta, što se nije dogodilo. Propust partnera omogućio je Anthropicovim razvojima da “izađu” iz testnog okruženja.
Tvrtka je trebala prepoznati da su modeli u više navrata izveli “nepravilnu” radnju. U ovom je slučaju zabrinjavajuće upravo to što doista nitko nije primijetio da je Anthropic s raznim varijantama Claudea izveo više hakerskih napada. Različiti slučajevi vezani su uz Opus 4.7, Mythos 5 i jedan interni istraživački testni model. Sami incidenti kibernetičke sigurnosti u načelu nisu bili toliko ozbiljni kao raniji slučaj Hugging Facea.
Cijela je ta afera sve problematičnija jer sada već izravno možemo govoriti o tome da tvrtke nisu samo potpuno gospodari vlastitih razvoja, nego ne mogu osigurati ni odgovarajući nadzor. A šlag na torti je to što i Anthropic, poput OpenAI-ja, sve to donekle prikazuje kao da je riječ o nečemu slavnom. Stručnjaci neumorno pozivaju na potrebu strože intervencije nadležnih tijela.